
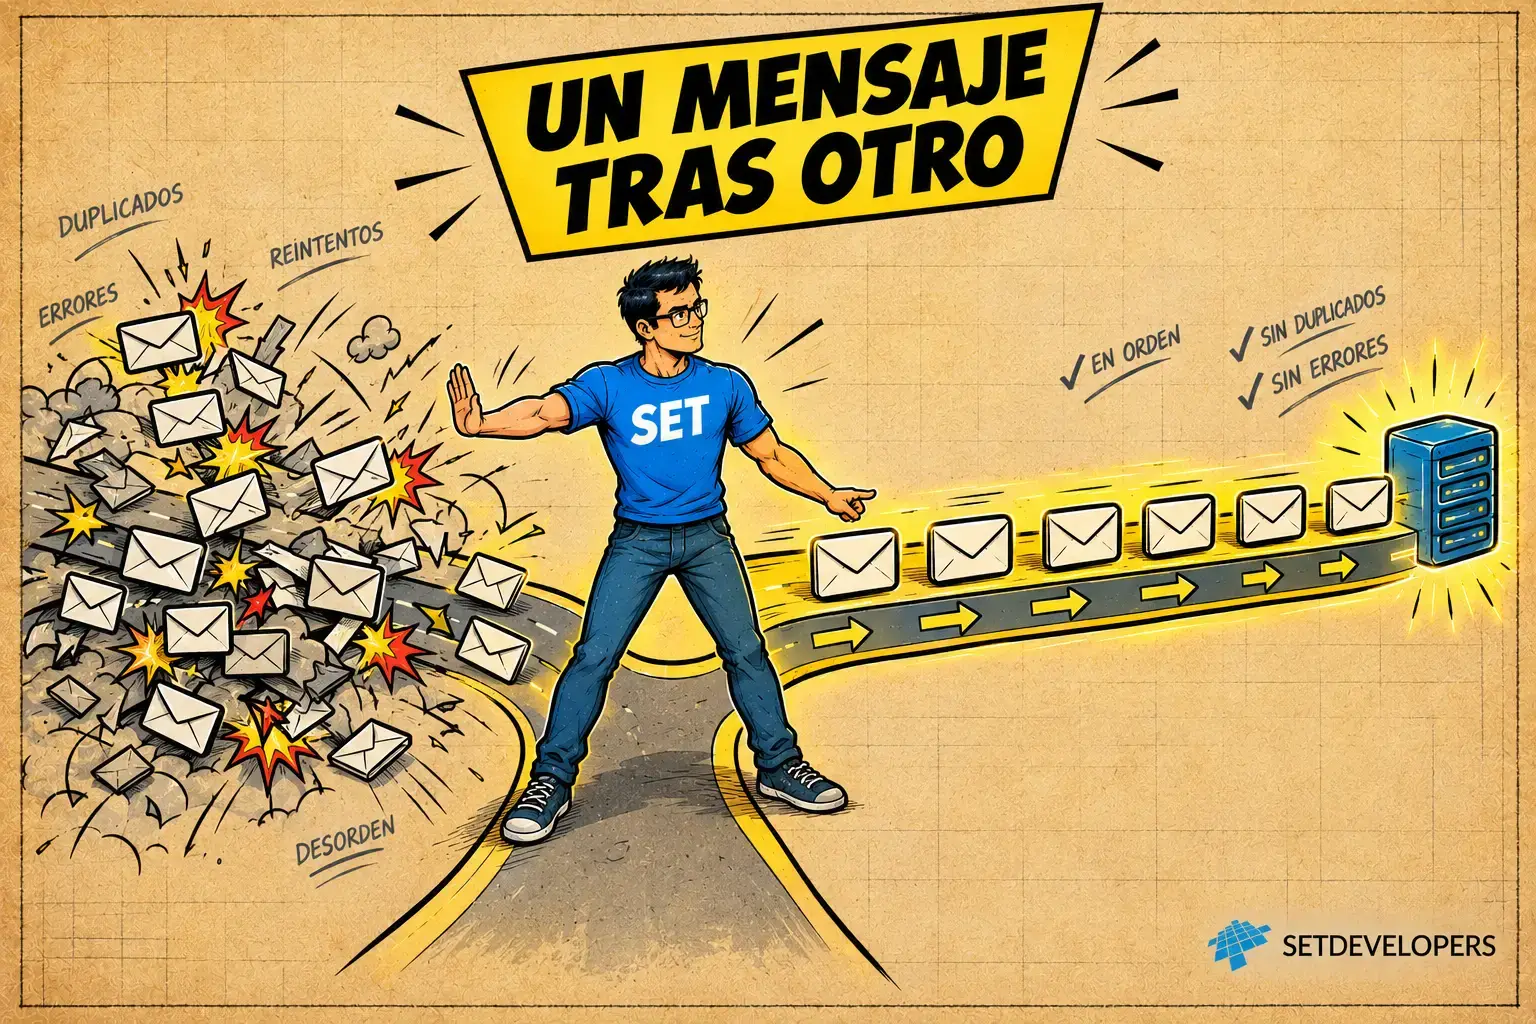
Kafka permite mover enormes volúmenes de mensajes entre servicios, pero escalar su consumo trae un problema que no aparece hasta que el sistema soporta carga real: cuando varias instancias procesan a la vez mensajes relacionados entre sí, el resultado deja de depender del código y pasa a depender del momento exacto en que ocurre cada cosa. Esto es lo que le pasaba a uno de nuestros clientes, y en SETDEVELOPERS resolvimos la concurrencia en Kafka utilizando Nuestro Framework para Backend.

Necesidad inicial
Datos consistentes en un sistema basado en eventos
El cliente tenía un Backend organizado en Microservicios que se comunicaban mediante Kafka. La arquitectura funcionaba y escalaba, pero el negocio necesitaba algo más que velocidad: que el estado de cada dato fuera siempre correcto, con independencia de cuántos mensajes llegaran ni de cuántas instancias los procesaran.
Escalar el consumo sin perder fiabilidad
Para absorber los picos de carga, el cliente había aumentado el número de instancias consumidoras. El objetivo era poder seguir creciendo sin que cada nueva instancia aumentara el riesgo de inconsistencias en los datos.
Backend con inconsistencias intermitentes en el procesamiento de mensajes
Mensajes relacionados procesados al mismo tiempo
El problema aparecía cuando dos mensajes que afectaban a un mismo dato eran recogidos por instancias distintas casi a la vez. Ambas leían el estado actual, aplicaban su cambio y lo guardaban, y la última en escribir pisaba el trabajo de la otra. El resultado era una actualización perdida, sin ningún error en los registros que la delatara.
Reintentos y reasignaciones que duplican el trabajo
Kafka garantiza que un mensaje se entrega al menos una vez, no exactamente una. Cuando una instancia se caía o el grupo de consumidores se reorganizaba, algunos mensajes volvían a procesarse. Sin un tratamiento específico, un mismo evento podía aplicarse dos veces y alterar los datos de forma silenciosa.
Fallos imposibles de reproducir
Todo esto ocurría de forma esporádica y dependía del orden exacto en el que se cruzaban los eventos. En un entorno de pruebas, con poca carga, el sistema se comportaba correctamente, lo que hacía casi imposible reproducir el fallo y dejaba al equipo persiguiendo incidencias que desaparecían antes de poder analizarlas.
Arquitectura de la solución para gestionar la concurrencia en Kafka
Ordenar por clave: un mismo dato, una misma partición
El primer paso fue publicar cada mensaje con una clave que identifica la entidad a la que afecta. Kafka garantiza el orden dentro de una partición, y todos los mensajes con la misma clave acaban en la misma. Así, los eventos que afectan a un mismo dato dejan de repartirse entre instancias y llegan siempre a un único consumidor, en el orden en que se produjeron.
Un flujo ordenado de acciones, sin actualizaciones simultáneas
El segundo paso fue cambiar cómo el Backend trata cada mensaje recibido. Con Nuestro Framework, cada mensaje se convierte en una acción que se procesa de forma estrictamente ordenada, una detrás de otra. El nuevo estado se calcula siempre a partir del anterior, y nunca hay dos actualizaciones del mismo dato compitiendo a la vez.
Procesamiento idempotente frente a los duplicados
Por último, el procesamiento se diseñó para que recibir dos veces el mismo mensaje produzca el mismo resultado que recibirlo una. De este modo, los reintentos y las reasignaciones de partición dejaron de ser un riesgo para la integridad de los datos.
Detalle de la implementación de Nuestro Framework para Backend
Kafka como detalle de infraestructura con Arquitectura Hexagonal
Nuestro Framework está implementado siguiendo la Arquitectura Hexagonal, por lo que Kafka queda como un recurso externo conectado mediante un adaptador. La lógica de negocio que decide cómo reaccionar a cada evento está completamente aislada de la mensajería, lo que permite probar los escenarios de concurrencia sin necesidad de levantar un clúster.
Redux como pilar de la arquitectura de datos
La capa de gestión de datos del Framework utiliza Redux como patrón central. Cada cambio sigue siempre el mismo camino: se recibe una acción, un reducer calcula el nuevo estado a partir del anterior y se persiste el resultado. Este flujo elimina de raíz las condiciones de carrera, porque no existe ningún camino alternativo para modificar un dato.
Telemetría de cada mensaje procesado
Cualquier acción ejecutada dentro del Framework genera una traza de telemetría en Elastic Stack o en cualquier plataforma compatible con OpenTelemetry. Esto permite seguir el recorrido de cada mensaje por el sistema y reconstruir con exactitud qué ocurrió y en qué orden cuando surge una incidencia.
Ventajas de gestionar la concurrencia en Kafka con Nuestro Framework
Datos consistentes con independencia de la carga
Las actualizaciones perdidas y los efectos de los mensajes duplicados desaparecieron. El sistema se comporta igual con diez mensajes que con diez millones, porque el orden de procesamiento ya no depende de la suerte con la que se crucen los eventos.
Escalado horizontal sin riesgo
Añadir instancias consumidoras deja de ser una apuesta. La consistencia está garantizada por el diseño y no por el número de instancias, así que el cliente puede crecer ajustando recursos sin revisar cada vez si la concurrencia seguirá bajo control.
Diagnóstico en minutos, no en días
Con cada mensaje trazado y un flujo determinista, reproducir una incidencia pasa de ser una tarea de horas a una consulta de telemetría. El equipo deja de perseguir fallos fantasma y vuelve a dedicar su tiempo a construir funcionalidades nuevas.
Un estándar que se replica en cualquier tecnología
El Framework está implementado de forma idéntica en Dotnet C#, NodeJS Typescript, Python y Flutter. La solución aplicada en este cliente es, por tanto, un patrón que podemos replicar en cualquier otro proyecto, con las mismas convenciones y el mismo nivel de calidad.
Si tu sistema con Kafka sufre inconsistencias de datos que nadie consigue reproducir, cuéntanos tu proyecto y analizamos juntos cómo devolverle la fiabilidad que necesita.